22 Agustus 2026
Evaluasi Duplicati sebagai Opsi Backup
Ulasan jujur Duplicati dari sudut pandang testing: setup interaktif lewat UI web, enkripsi dan deduplikasi bawaan, plus pro-kontra untuk homeserver satu mesin dengan storage terbatas.
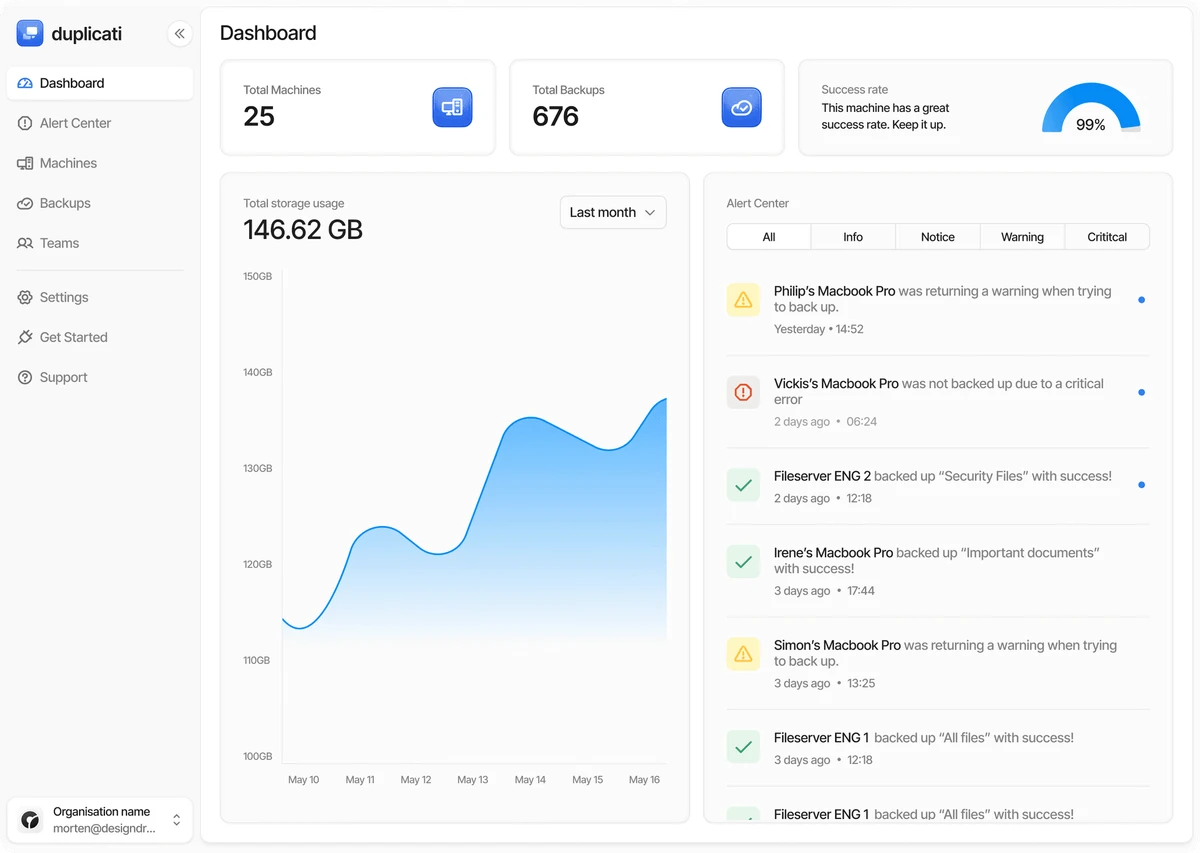
Bukan rahasia lagi bahwa backup itu hal yang sering ditunda. Di homeserver, saya punya satu mesin fisik dan media storage yang terbatas, jadi strategi backup tidak bisa asal jalan. Belakangan saya meluangkan waktu untuk testing beberapa opsi backup, dan salah satu yang mencolok adalah Duplicati. Artikel ini adalah catatan evaluasi, bukan klaim bahwa saya sudah memakainya untuk semua service. Sebagian besar justru masih dalam tahap uji coba.
Yang menarik dari Duplicati adalah ia menawarkan pendekatan yang berlawanan dengan kebanyakan alat backup self-hosted: bukan command-line yang menakutkan, tapi antarmuka web yang interaktif dengan wizard. Untuk satu orang yang ingin backup berjalan tanpa ribut, ini poin awal yang bagus.
Kenapa sempat dipertimbangkan
Sebelum Duplicati, saya sudah pakai beberapa pendekatan lain: snapshot manual, rsync terjadwal, dan backup level-VM lewat Proxmox Backup Server. Semuanya jalan, tapi ada celah yang mengganggu:
- Snapshot dan
rsynctidak terenkripsi secara bawaan, jadi media backup harus dipercaya. - Backup level-VM bagus, tapi restore satu file atau satu aplikasi jadi berat dan tidak cepat.
- Konfigurasi lewat terminal butuh catatan rapi, mudah lupa.
Duplicati menjawab tiga hal itu sekaligus: terenkripsi bawaan, deduplikasi + kompresi, dan semuanya dikelola dari web. Inilah yang membuat saya memutuskan untuk mencobanya.
Pengalaman pertama kali
Pemasangan via Docker Compose cukup singkat, dan begitu kontainer jalan, saya langsung disambut setup wizard di browser. Ini kebalikan dari gaya CLI: pilih sumber, tentukan tujuan, atur jadwal, dan biarkan Duplicati menghitung sisanya. Untuk orang yang tidak ingin menghafal ratusan flag, pengalaman ini jauh lebih mudah.
services:
  duplicati:
    image: lscr.io/linuxserver/duplicati:latest
    container_name: duplicati
    environment:
      - PUID=1000
      - PGID=1000
      - TZ=Asia/Jakarta
    volumes:
      - ./config:/config
      - ./backups:/backups
    ports:
      - "8200:8200"
    restart: unless-stopped
Setelah itu, tambahkan folder atau volume ke dalam job lewat UI, atur lokasi target backup, dan Duplicati yang melakukan enkripsi, deduplikasi, serta kompresi secara otomatis. Ada juga scheduler bawaan dan laporan status antar-job yang bisa dipantau dari satu dasbor. Sebagai pengalaman awal, ini sangat mudah dipahami.
Kelebihan yang saya rasakan
- UI interaktif yang lengkap. Wizard setup, laporan, eksplorasi isi backup (browse backup file), bahkan restore dari browser. Semua bisa dijalankan tanpa menyentuh terminal.
- Enkripsi bawaan (AES-256). Data dienkripsi sebelum meninggalkan proses, jadi target backup tidak perlu sepenuhnya dipercaya.
- Deduplikasi dan kompresi. Ini krusial untuk storage terbatas — data yang sama tidak diunggah berulang-ulang, dan hasilnya lebih kecil dari ukuran asli.
- Incremental + scheduler. Hanya backup pertama yang penuh; sisanya diferensial, sehingga hemat bandwidth dan kapasitas.
- Banyak pilihan tujuan. FTP, WebDAV, SFTP, dan berbagai penyimpanan cloud, jadi tidak terkunci pada satu target.
Kontra dan keterbatasan, terutama untuk satu mesin
Evalulasi tidak lengkap tanpa sisi negatif. Di konteks homeserver satu mesin dengan storage terbatas, kontra ini cukup terasa:
- Deduplikasi butuh ruang. Semua data mampat disatukan di dalam satu data store yang besar. Artinya, backup sebagai satu kesatuan, dan UI kadang tidak memperlihatkan ukuran per-item dengan jelas. Ini menyulitkan saat ingin tahu “seberapa besar sebenarnya folder ini di dalam backup”.
- Konsumis penyimpanan tidak transparan. Walau dedup+kompresi membantu, memperkirakan kapan disk akan penuh tetap sulit. Untuk storage yang sangat terbatas, ini perlu dipantau ketat.
- Restore bisa lambat dan menggabungkan semua operasi. Duplicati bekerja dalam blok; pemulihan satu file umumnya cepat, tapi restore penuh kadang menarik banyak blok terenkripsi dari data store yang sama.
- Recovery bergantung pada database. Duplicati menyimpan metadata job di database lokal. Jika database hilang, menguraikan kembali semua blok menjadi jauh lebih rumit. Ini berarti media penyimpanan dan database harus dijaga bersama-sama.
- “Backup di mesin yang sama” = satu failure domain. Jika satu-satunya salinan target berada di disk yang sama dengan data sumber, itu bukan backup yang utuh. Ia melindungi dari kehilangan file, tapi tidak dari kehilangan seluruh mesin. Untuk benar-benar aman tetap butuh salinan off-host atau offsite.
- Dokumentasi berbasis istilah. Loop, data store, versi, dan istilah lain punya kurva belajar tersendiri, meski UI-nya ramah.
Kesimpulan sementara
Sejauh ini, Duplicati pantas disebut sebagai salah satu opsi backup yang paling mudah diakses: UI web interaktif, enkripsi dan deduplicasi bawaan, dan konfigurasi yang jauh lebih ramah dibanding alat CLI. Untuk tujuan “backup aplikasi dengan mudah dan dipantau dari satu dasbor”, ia bekerja sangat baik.
Tapi ia juga bukan jawaban ajaib untuk keterbatasan saya. Dengan satu mesin dan storage yang terbatas, tantangannya bukannya soal fitur, melainkan ketersediaan salinan yang benar-benar terpisah dan perencanaan kapasitas. Duplicati membantu dari sisi kemudahan dan keamanan pada level data, tetapi tetap butuh disiplin dari sisi lokasi penyimpanan target.